2026年06月24日
AIエージェント×基幹系データの実践手法
— AWS × SAP × Databricks によるデータ活用アーキテクチャ —
企業においてAIエージェント活用の取り組みが急速に進む中、成果創出にあたり様々な壁に直面しています。例えば、企業内に蓄積された基幹系システム等のデータと生成AIをつなぐことで効果創出を狙う中、データが基幹系システム製品(パッケージやサービス)に閉じられ、かつAI利用はその製品固有のものに限定されるといった制約に悩まされる場合があります。さらに、基幹系だけでなく営業系データなども含めた企業全体の業務データを一気通貫で処理できるAIエージェントを実現しようとした際の実現手法や、ガバナンス観点の懸念にどう対応したらよいか分からないという声も多く聞かれます。
こうした状況に対し、例えば2025年から2026年にかけて見られたSAP・Databricks・AWS各社の連携をみていくと、データのオープン化や、AIエージェント機能の発展により、対応の選択肢が生まれてきています。
本記事では、我々が企業のデータ基盤整備やAIエージェント開発の伴走を行う中で整理した「基幹システムデータをAIエージェントで活用する手法」をご紹介します。
AI活用の実態と、成果を阻む壁
本題に入る前に、関連する企業動向や課題を改めて整理します。PwC JapanやNRIなどの調査によると、国内企業でのAI活用の取り組みは着実に広がっています。
・参考:PwC「生成AIに関する実態調査 2025春 5カ国比較」
https://www.pwc.com/jp/ja/knowledge/thoughtleadership/generative-ai-survey2025.html
・参考:NRI「ユーザー企業のIT活用実態調査(2025年)」
https://www.nri.com/jp/news/newsrelease/20251125_1.html
一方で、ビジネス効果を実感できている企業は限定的というのが実情です。複数のお客様と議論する中で見えてきた要因は、主に以下の3点で整理しています。
1.データ未整備
AIに活用させるべき業務データが社内に散在したまま、またメタデータなどを整備する仕組みがなく、AIを活用できる状態になっていない。
2.基幹システム連携の難しさ
SAPなどの基幹システム製品から必要なデータをAI側に引き出すことが技術的に容易でなく、かつ製品のAI機能が個別に動くだけで、業務や製品横断での活用につながらない。
3.ガバナンス不足
品質管理・統制・権限管理といった足回りの整備が、AI活用の速度に追いついていない。特にエージェントが増えるほど、ガバナンスの設計が複雑になる。
これらを前提とした場合の解決アプローチとしては、基幹システム連携を前提としたデータ基盤の導入及びデータ・メタデータ整備、AIエージェントの横断的ガバナンス実現に向けたアーキテクチャの選定・導入が選択肢に挙がります。
SAP × Databricks × AWSの連携
次に前述の課題解決に寄与するハイパースケーラーやソリューションベンダー各社の動きをご紹介します。2025年から2026年にかけての関連動向を整理すると次の通りです。
・ SAP:基幹システムで保持するデータの公開
SAP Business Data CloudにてDatabricksとのネイティブ統合を発表。Delta Sharingによるゼロコピー連携により、SAPの基幹データをAI基盤から直接参照できる環境が整う。
・ Databricks:データ統合プラットフォームの進化
Unity CatalogやDelta Sharingによるデータ統合管理・ゼロコピー共有を実現し、各ドメインにデータを分散保持しながらも、中央集権的なカタログ管理・アクセス制御・リネージ追跡を単一プラットフォームで実現。Lakeflow ConnectによるSaaSやデータベース製品とのシームレスなデータ連携機能がGA。
・ AWS:AIエージェント基盤の位置づけ
Amazon Bedrock AgentCoreがGA。豊富なガバナンス機能を背景に、複数エージェントのオーケストレーション層としての役割が実現可能となった。さらにBedrock AgentCore経由で外部製品とのMCP連携も可能となった。加えて、Kiroを通じたSAP開発の効率化モデルも提唱された。
・SAP Business Data Cloud Connect to Databricks の一般提供開始を発表します | Databricks Blog
・Lakeflow Connect の一般提供開始を発表 | Databricks Blog
・Amazon Bedrock AgentCore の一般提供を開始 - AWS
・Kiro Agent で SAP Clean Core ジャーニーを加速する | Amazon Web Services ブログ
3社の動向を俯瞰すると「SAPが基幹データ・ビジネスプロセスを担い、Databricksがデータを支え、AWSが業務横断AIエージェント基盤として全体をつなぐ」という連携像が見えてきます。それぞれが単独で完結するのではなく、組み合わせることで初めて「つながる企業AI」が実現できるという点が重要です。
実際の取り組みから見えてきたこと
ここからは我々が企業の支援を通じて行った実践例をご紹介します。
事例①:製造業A社様 ──業務横断AIの実現へ
A社では、基幹系データ・外部データ・構造化/非構造化データを統合したデータ基盤を構築し、その上でAIエージェントによる業務効率化・高度化の実現を目指しています。
システム構成としては、各事業部門がそれぞれで利用していたAIエージェントのオーケストレーションにAmazon Bedrock AgentCoreを採用(既存のAWSインフラとの親和性が高く、マルチエージェント協調からガバナンスまでを単一プラットフォームで完結できる点が選定の決め手)。エージェントの動的処理にAWS Lambdaやその他AIエージェント製品(Dify等。ホスティングにAmazon EC2使用)を組み合わせています。また、既存のAWS資産を最大限に活かしながらDatabricksとの連携によるデータ活用を進めています。
データ基盤にDatabricksを選択した背景には、データメッシュの考え方がありました。各部門やシステムが保有するデータをそれぞれの場所に保持したまま、Unity Catalogによる中央集権的なカタログ管理・アクセス制御・データリネージを実現できる点が大きな特徴です。既存データ資産の移行を最小化しながらAWS上の現行資産を活用することで、段階的なAIエージェントの導入を進めています。
このようなアーキテクチャの中で、AWSはAIエージェントのオーケストレーション層としての役割を果たすなど大きく以下の3つのようなメリットがありました。
1. 業務横断オーケストレーション
Amazon Bedrock AgentCoreのマルチエージェント協調機能により、複数の周辺システム・データベース・社内API等をまたいだ業務横断エージェントを単一基盤で構築・管理できる点は、個別製品のAIプラットフォーム等には難しい領域のため、この点にAWSを活用するメリットがある。
2. カスタマイズ性
製品標準機能やレガシーシステムで賄えない要件をAWSサービスで補完し、段階的なAIエージェント化を進めるうえで、この柔軟性は選択肢の増加に寄与する。
3. ガバナンス対応
Amazon Bedrock AgentCoreを採用したことで、AIエージェントに関わるネットワーク・ログ・コスト管理を1プラットフォームで一元化し、エージェントが増えても同一のガバナンスルールの自動適用が可能。ISMAP・IAM・監査証跡・Guardrailsといったエンタープライズ要件への対応も、この構成があってこそ現実的になる。
事例②:メーカーB社様 ── SAPデータを「AIが使える形」に
B社ではSAPデータのAI活用を目指し、SAP S/4HANAで持つ指図実績・BOM・購買実績・会計データや、Excel等SAP外の現場データをDatabricks on AWS(基盤ストレージにAmazon S3を使用)で統合し、AIエージェントによるデータ分析の高度化を進めています。具体的なシステム構成は以下の通りです。
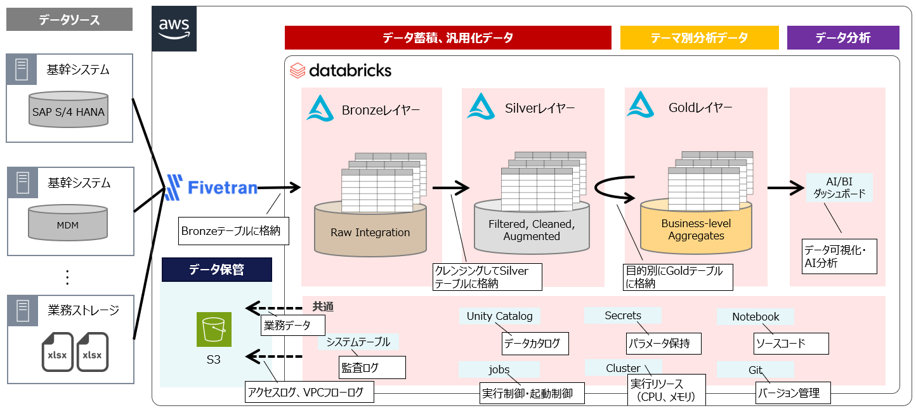
本取り組みを通じて気づいたのは、「SAPデータはそのままではAIが扱いにくい」という点です。特にSAPのテーブル名やカラム名は独特な識別子で管理されており、業務上の意味・単位・コード値の解説といったメタデータを丁寧に整備して初めて、AIがデータの文脈を正しく理解できるようになります。またデータを体系化しAIが理解できる形に整えることで初めてその真価を発揮します。この実現に向けDatabricksが提供するデータカタログやAI機能は大きく寄与しました。
この足回り整備の後、経営・現場・財務・ITが同じデータを共通言語として議論できる状態になることが、組織におけるデータ・AI活用の起点になると感じています。
段階的に進めるためのアプローチ
これらの取り組みを改めて振り返ると、一足飛びに全社最適を目指すのではなく、段階を踏んで進めることが成果につながるという共通点が見えています。
Step 1:スモールスタートで手触り感を得る
まず効果を得やすいユースケースから始め、現場が「使えた」という体験を積み重ねながら、実績をもとにしたAI精度やガバナンス観点の課題を洗い出します。この体験はその後の展開において非常に重要です。
Step 2:ガバナンス環境の整備
スモールスタートで得た知見をもとに、ガバナンスルールや環境整備を本格化します。このフェーズの丁寧さが、Step 3以降のスケールを大きく左右します。
Step 3:全社展開とビジネス成果の拡大
整備された基盤をもとに、AIアプリ・AIエージェントによる業務効率化・高度化ノウハウを全社に展開し、ビジネス成果の拡大へとつなげます。
おわりに
基幹システムをAIと繋ぎ効果を得るための手法や実践例をご紹介しました。最後にこれらの内容から得られるポイントを整理します。
・各製品やサービスの特徴や強みを生かした「連携」を実現することが重要
・SAP × Databricks × AWSのような連携はその代表例
・スモールスタートで効果や課題の実践知を積み重ねながら、段階的に全社展開へとつないでいく
本記事が、自社のAI・データ活用の次の一手を考えるきっかけになれば幸いです。